
Введение
Запуск веб-сервиса не заканчивается кнопкой "опубликовать". После релиза начинается реальная эксплуатация: пользователи регистрируются, отправляют формы, оплачивают заказы, открывают личный кабинет, работают с документами, получают уведомления, используют API, ждут статусы из CRM и возвращаются в продукт через разные устройства. В этот момент становится важно не только то, что сервис был протестирован перед запуском, но и то, как команда видит его состояние после запуска.
Мониторинг веб-сервиса нужен, чтобы команда узнавала о проблемах раньше пользователей или хотя бы одновременно с ними, а не через потерянные заявки, жалобы, падение рекламы и снижение доверия. Если форма не отправляет лиды в CRM, платежный webhook не обновляет статус, очередь сообщений остановилась, база данных заполняет диск, API отвечает медленнее обычного, SSL-сертификат скоро истечет или на сервере растет число ошибок 500, бизнес должен увидеть это быстро.
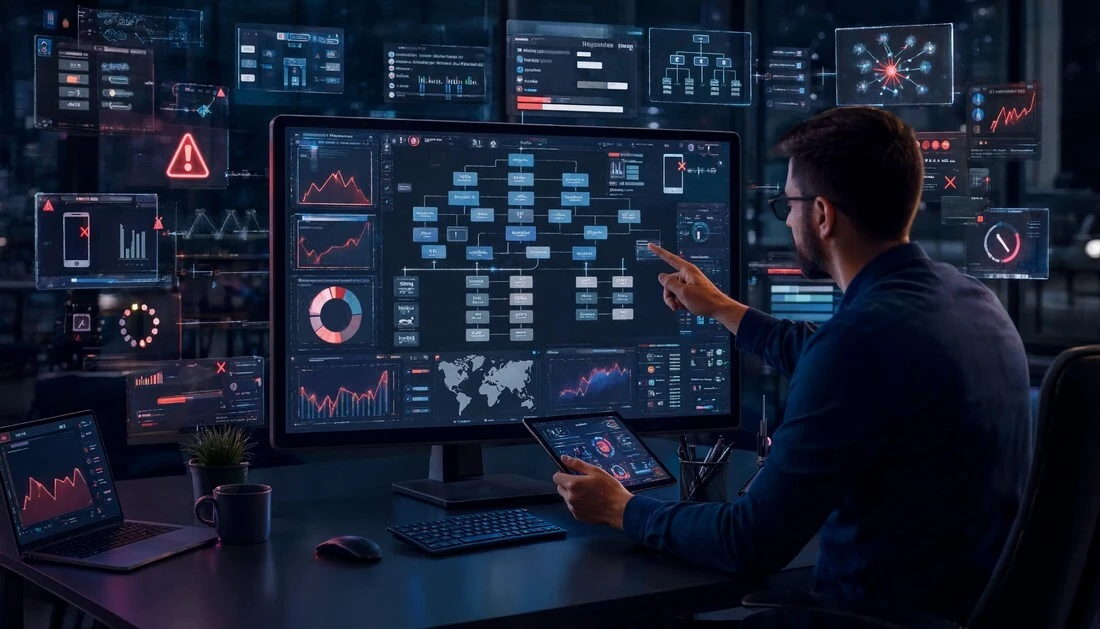
Но мониторинг - это не один график uptime. Хорошая система наблюдения за продуктом включает доступность, скорость, ошибки, логи, метрики, трассировку запросов, алерты, статусы интеграций, контроль фоновых задач, dashboard для команды и понятный процесс реакции на инциденты.
Главная цель мониторинга проста: не просто узнать, что "что-то сломалось", а понять, что именно сломалось, кого это затронуло, насколько это критично, кто отвечает за реакцию и что нужно сделать, чтобы проблема не повторилась.
Как связать эти сигналы с резервными копиями, релизами и действиями команды, показываем в разделе Надежность веб-сервиса после запуска.
При частых обновлениях полезно связать сигналы с feature flags: новую функцию можно включать постепенно и остановить, если для этой группы выросло число ошибок.
Чем мониторинг отличается от поддержки после запуска
Поддержка после запуска - более широкая тема. Она включает исправления, обновления, безопасность, SEO, контент, резервные копии, доработки, сопровождение релизов и развитие продукта. Мониторинг - это один из ключевых элементов поддержки, но у него отдельная задача: непрерывно наблюдать за состоянием сервиса и сигнализировать о проблемах.
Если поддержку можно сравнить с регулярным обслуживанием продукта, то мониторинг - это система датчиков. Она не чинит сервис сама по себе, но показывает, где начинается сбой.
Мониторинг отвечает на вопросы:
- доступен ли сервис пользователям;
- работают ли ключевые сценарии;
- есть ли рост ошибок;
- не замедлились ли важные операции;
- принимаются ли платежи;
- уходят ли заявки в CRM;
- обрабатываются ли очереди;
- доставляются ли уведомления;
- хватает ли ресурсов серверу;
- не приближается ли технический лимит;
- кто уже получил алерт;
- сколько длится инцидент;
- что изменилось перед проблемой.
Тема поддержки после запуска подробно раскрыта в статье Поддержка и развитие веб-проекта после запуска. Здесь фокус уже: что именно измерять, какие сигналы собирать и как реагировать на сбои в продакшене.
Почему одного uptime недостаточно
Многие начинают мониторинг с проверки "сайт открывается или нет". Это нужно, но этого мало. Веб-сервис может быть доступен по HTTP, главная страница может возвращать 200 OK, но при этом бизнес-процесс уже сломан.
Примеры:
- сайт открывается, но форма заявки не отправляется;
- личный кабинет загружается, но документы не скачиваются;
- оплата проходит у банка, но статус заказа не обновляется;
- регистрация работает, но письмо подтверждения не отправляется;
- API отвечает, но возвращает неполные данные;
- админка доступна, но фильтр заявок падает с ошибкой;
- CRM принимает не все лиды;
- очередь задач растет и не обрабатывается;
- пользователь видит страницу, но она загружается 12 секунд;
- поиск работает, но не показывает часть объектов;
- cron-задача не запустилась ночью;
- webhook внешнего сервиса возвращает 400 или 500;
- на сервере заканчивается место, но сайт пока еще жив.
Поэтому мониторинг веб-сервиса должен смотреть не только на доступность страницы, но и на критические действия. Для бизнеса важно не абстрактное "сервис жив", а "пользователь может выполнить целевое действие, а данные доходят туда, куда должны".
Мониторинг и наблюдаемость: в чем разница
Мониторинг показывает заранее выбранные показатели: доступность, время ответа, количество ошибок, нагрузку, длину очереди, свободное место на диске, статус фоновых задач. Он отвечает на вопросы, которые команда уже ожидает.
Наблюдаемость, или observability, шире. Она помогает разбираться с новыми, заранее неизвестными проблемами. Для этого сервис должен отдавать достаточно данных: метрики, логи, трассировки, контекст запроса, ID пользователя или организации, статус операции, внешние зависимости, версию релиза.
OpenTelemetry описывает три базовых сигнала наблюдаемости: traces, metrics и logs. Метрики показывают численные агрегаты, логи фиксируют события, трассировки помогают увидеть путь запроса через несколько компонентов. Для современного веб-сервиса все три слоя важны, потому что проблема редко живет в одном месте.
Например, пользователь нажал "Оплатить". Запрос прошел через frontend, backend, платежный API, webhook, очередь, базу данных, уведомление и CRM. Если статус не обновился, обычный uptime не поможет. Нужны логи, метрики и trace, чтобы понять, где цепочка остановилась. Такой подход хорошо виден в кейсе платформы наблюдаемости для микросервисов: там метрики, логи и трассировки помогают быстро находить место деградации.
Хотите запустить похожий проект?
Опишите задачу, и команда Wcoders подскажет, какой формат подойдет: MVP, Telegram Mini App, веб-сервис, интеграция или аудит текущего продукта.
Четыре главных сигнала веб-сервиса
Google SRE Book выделяет четыре золотых сигнала мониторинга: latency, traffic, errors и saturation. Для веб-сервиса их можно перевести на практический язык.
Latency - время ответа. Пользователь может открыть страницу, отправить форму или выполнить API-запрос, но если ответ приходит слишком долго, сервис воспринимается как нестабильный. Важно смотреть не только среднее время, но и перцентили, например p95 и p99. Среднее значение может выглядеть нормально, пока часть пользователей регулярно ждет слишком долго.
Traffic - поток запросов и операций. Это количество HTTP-запросов, регистраций, заявок, оплат, API-вызовов, фоновых задач, webhook-событий, писем и других действий. Резкое падение трафика может означать проблему с входом, рекламой, DNS, frontend или аналитикой. Резкий рост может привести к перегрузке.
Errors - ошибки. Это не только HTTP 500. Ошибкой может быть неуспешная отправка формы, отклоненный webhook, сбой платежа, таймаут CRM, ошибка валидации, ошибка очереди, недоставленное уведомление, неудачная авторизация, отказ внешнего API.
Saturation - насыщение ресурсов. Сервис может работать, но быть близким к пределу: CPU, память, диск, база данных, соединения, очередь задач, лимиты внешнего API, лимиты почтового провайдера. Часто насыщение видно до падения сервиса, и хороший алерт помогает среагировать заранее.
Эти сигналы не заменяют бизнес-метрики, но дают техническую основу. Если веб-сервис принимает заявки, продает билеты, обрабатывает платежи или обслуживает B2B-клиентов, технические сигналы нужно дополнить продуктовыми и операционными.
Какие уровни мониторить
Мониторинг должен покрывать несколько уровней. Если смотреть только на сервер, можно пропустить сломанную бизнес-логику. Если смотреть только на бизнес-события, можно не увидеть приближающийся технический сбой.
Уровни мониторинга:
- внешняя доступность;
- frontend;
- backend;
- API;
- база данных;
- файловое хранилище;
- очереди и фоновые задачи;
- внешние интеграции;
- платежи;
- уведомления;
- CRM и 1С;
- админ-панель;
- безопасность;
- SEO-критичные страницы;
- продуктовые действия.
Для маленького сайта часть этих уровней может быть избыточной. Для веб-сервиса с заявками, оплатой, личным кабинетом и интеграциями они становятся нормой.
Внешняя доступность
Внешний мониторинг проверяет, доступен ли сервис снаружи. Обычно это HTTP-проверки из разных регионов, контроль статуса ответа, времени загрузки, SSL-сертификата, DNS и редиректов.
Что стоит проверять:
- главную страницу;
- страницу входа;
- форму заявки;
- публичный каталог;
- личный кабинет;
- endpoint API;
- webhook endpoint;
- страницу оплаты или возврата;
- sitemap и robots.txt для SEO-проекта;
- статус SSL-сертификата;
- корректность редиректов.
Проверка главной страницы раз в минуту полезна, но для веб-сервиса стоит добавить synthetic monitoring: имитацию реального сценария. Например: открыть форму, заполнить тестовые данные, отправить запрос, проверить успешный ответ. Такой тест лучше показывает реальную работоспособность продукта.
Важно не делать synthetic-тесты опасными. Они не должны создавать реальные заказы, реальные платежи, спамить менеджерам или портить аналитику. Для этого нужны тестовые признаки, отдельный environment, фильтрация тестовых событий или безопасный сценарий проверки.
Frontend-мониторинг
Пользователь видит frontend. Даже если backend работает идеально, ошибка JavaScript, сломанный bundle, конфликт браузера, неудачный deploy или сбой CDN могут остановить сценарий.
Frontend-мониторинг должен показывать:
- JavaScript-ошибки;
- ошибки загрузки ресурсов;
- проблемы на конкретных браузерах;
- медленные страницы;
- ошибки отправки форм;
- сбои авторизации на клиенте;
- проблемы мобильной версии;
- frontend-версию релиза;
- URL, где произошла ошибка;
- user agent и устройство;
- связь ошибки с конкретным действием.
Особенно важно не собирать лишние персональные данные. В логи frontend-ошибок не должны уходить пароли, токены, номера карт, полные документы, персональные сообщения и другие чувствительные поля.
Backend-мониторинг
Backend отвечает за бизнес-логику: заявки, статусы, пользователей, платежи, интеграции, документы, права доступа, уведомления, очереди. Если backend работает неправильно, пользователь может не увидеть ошибку сразу, но бизнес уже потеряет данные.
Что мониторить на backend:
- HTTP-статусы;
- время ответа endpoints;
- частоту ошибок;
- исключения приложения;
- таймауты;
- ошибки базы данных;
- ошибки внешних API;
- rate limit;
- статус очередей;
- фоновые задачи;
- потребление памяти и CPU;
- количество активных соединений;
- версию приложения;
- успешность критических операций.
Для backend особенно полезны структурированные логи. Вместо строки "error occurred" лог должен содержать событие, сервис, endpoint, request ID, user ID или company ID при допустимости, статус операции, код ошибки, длительность, external service, correlation ID и версию релиза.
API и интеграции
Если веб-сервис связан с CRM, 1С, платежами, email, Telegram, складами, картами, аналитикой или внешним API, мониторинг должен видеть не только собственный код, но и состояние обмена.
Для API-интеграций важно отслеживать:
- количество успешных запросов;
- количество ошибок по каждому внешнему сервису;
- таймауты;
- повторные попытки;
- ответы 400, 401, 403, 429, 500;
- изменение схемы ответа;
- устаревшие токены;
- скорость ответа внешнего сервиса;
- очередь на повторную отправку;
- последние успешные синхронизации;
- расхождения статусов.
Общая архитектура таких связей описана в статье Разработка платформы с API. Для мониторинга важно, чтобы каждая интеграция была не черным ящиком, а управляемым процессом с логами, статусами, retry и видимостью в админке.
Мониторинг CRM-заявок
Интеграция с CRM особенно чувствительна, потому что ее сбой напрямую бьет по продажам. Форма на сайте может показать пользователю "заявка отправлена", но если лид не попал в CRM, менеджер не свяжется с клиентом. Для бизнеса это не техническая мелочь, а потерянная возможность.
Что нужно контролировать:
- сохранение заявки на стороне сайта;
- успешную передачу в CRM;
- ответ CRM;
- назначение ответственного;
- сохранение UTM-меток;
- обработку дублей;
- ошибки валидации полей;
- недоступность CRM;
- повторную отправку;
- очередь неотправленных заявок;
- уведомление менеджера при сбое.
Хорошая схема не теряет заявку даже при недоступной CRM. Сайт должен сохранить данные, показать понятное подтверждение пользователю и поставить передачу в повторную обработку. Подробно логика заявок и CRM описана в статье Интеграция сайта с CRM.
Мониторинг платежей
Платежный сценарий нельзя контролировать только по странице "спасибо". Надежный статус должен приходить от платежного провайдера через серверный webhook или API-проверку. Если пользователь оплатил, а заказ не обновился, возникает спорная ситуация.
Что мониторить:
- создание платежа;
- переход к оплате;
- webhook от провайдера;
- финальный статус;
- ошибки подписи webhook;
- дубли webhook;
- задержку между оплатой и обновлением статуса;
- неуспешные платежи;
- возвраты;
- подписки и повторные списания;
- чеки;
- расхождение суммы;
- платежи в неизвестном статусе.
Алерт нужен не на каждый отклоненный платеж пользователя, потому что часть отказов нормальна: недостаточно средств, отмена, неверные данные. Алерт нужен на системные признаки: webhook не приходит, подпись не проходит, растет число ошибок провайдера, статусы зависают, чек не создается, возврат не фиксируется.
Тема платежной архитектуры раскрыта отдельно в статье Платежи в веб-сервисе. Мониторинг платежей должен быть частью этой архитектуры с первого релиза.
Очереди и фоновые задачи
Очереди помогают не блокировать пользователя долгими операциями: отправкой писем, передачей в CRM, обработкой файла, генерацией документа, проверкой платежа, пересчетом отчета. Но очередь сама по себе становится критичным компонентом. Если worker остановился, пользователь может видеть успешный экран, а действие внутри системы не завершится.
Что контролировать:
- длину очереди;
- возраст самой старой задачи;
- скорость обработки;
- количество failed jobs;
- количество retry;
- dead letter queue;
- время выполнения задач;
- статус worker-процессов;
- повторяющиеся ошибки;
- задачи по расписанию;
- ручной перезапуск задач из админки.
Если задача не обработалась один раз, это может быть штатный retry. Если очередь растет 20 минут, а worker не успевает, это уже риск. Если задача перешла в dead letter queue, команда должна увидеть причину и владельца.
Подробно очереди и фоновые процессы разобраны в статье Очереди и фоновые задачи в веб-сервисе. В мониторинге важно не просто иметь очередь, а видеть ее здоровье.
Уведомления и алерты для пользователей
Уведомления в продукте и алерты для команды - разные вещи. Пользователь получает письмо, SMS, push или Telegram-сообщение о своем событии: заявка принята, платеж прошел, документ готов. Команда получает алерт о проблеме: письма не отправляются, SMS-провайдер возвращает ошибки, Telegram API недоступен, очередь уведомлений растет.
Для уведомлений нужно мониторить:
- создано ли сообщение;
- ушло ли оно в очередь;
- отправлено ли провайдеру;
- получен ли статус доставки;
- есть ли bounce или отказ;
- нет ли массового роста ошибок;
- не превышены ли лимиты;
- корректно ли работают шаблоны;
- есть ли fallback-канал для критичных событий.
Отдельная статья Система уведомлений в веб-сервисе объясняет статусы доставки и каналы. В мониторинге важно связать эти статусы с инцидентами: если уведомления не уходят, команда должна узнать раньше, чем пользователи начнут спрашивать, где подтверждение.
Логи: что писать и чего избегать
Логи помогают понять, что произошло. Но плохие логи почти бесполезны: слишком много шума, нет контекста, нет ID запроса, ошибки разрознены, данные пишутся текстом без структуры, чувствительная информация попадает в хранилище.
Хороший лог содержит:
- время события;
- уровень важности;
- название сервиса;
- окружение;
- версию релиза;
- request ID;
- trace ID;
- действие;
- результат;
- код ошибки;
- длительность;
- внешний сервис;
- безопасный идентификатор пользователя или компании;
- понятное сообщение для разработчика.
Чего не должно быть в логах:
- паролей;
- токенов доступа;
- полных данных банковских карт;
- секретных ключей;
- лишних персональных данных;
- содержимого приватных документов;
- одноразовых кодов подтверждения;
- cookie и session tokens.
Логи должны помогать расследованию, а не создавать новые риски. Это особенно важно для сервисов с платежами, документами, персональными данными и личными кабинетами.
Метрики: что считать
Метрики нужны для численной картины. Они показывают динамику: стало ли больше ошибок, выросла ли задержка, закончивается ли диск, просел ли поток заявок, увеличилось ли время обработки очереди.
Базовые технические метрики:
- uptime;
- response time;
- p95 и p99 latency;
- error rate;
- requests per second;
- CPU;
- memory;
- disk usage;
- database connections;
- cache hit rate;
- queue length;
- job duration;
- external API latency.
Операционные метрики:
- заявки в CRM;
- платежи в ожидании;
- ошибки webhooks;
- недоставленные уведомления;
- незавершенные импорты;
- неуспешные фоновые задачи;
- неотправленные документы;
- ошибки входа;
- блокировки аккаунтов;
- просроченные SLA-операции.
Продуктовые метрики:
- регистрации;
- первый вход;
- активация;
- отправка формы;
- создание заказа;
- переход к оплате;
- повторные действия;
- конверсия ключевых сценариев.
Продуктовая аналитика и мониторинг пересекаются, но не заменяют друг друга. Аналитика отвечает на вопрос "как пользователи ведут себя в продукте", мониторинг - "работает ли продукт технически и операционно". Связка этих слоев дает полную картину.
Трассировка запросов
Трассировка, или distributed tracing, нужна, когда один пользовательский запрос проходит через несколько компонентов. Например, API gateway, backend, база данных, платежный сервис, очередь, worker, CRM и уведомление.
Trace помогает увидеть:
- путь запроса;
- где потрачено время;
- какой сервис вернул ошибку;
- какие операции были вложенными;
- какой external call затормозил;
- как связаны logs и metrics;
- что изменилось после релиза.
Без трассировки команда часто ищет проблему вручную по разным логам. С трассировкой можно быстрее понять, что заявка сохранилась, но передача в CRM упала на таймауте, а повторная задача зависла в очереди.
Для монолитного проекта трассировка тоже может быть полезна, особенно если внутри есть внешние API, платежи и фоновые задачи. Для микросервисов она почти обязательна.
Алерты: когда нужно будить команду
Главная ошибка алертов - отправлять слишком много сигналов. Если команда получает десятки сообщений в день, люди начинают игнорировать уведомления. Алерт должен означать: есть проблема, которая требует реакции.
Хороший алерт:
- связан с влиянием на пользователей или бизнес;
- содержит понятное описание;
- показывает критичность;
- указывает сервис;
- содержит ссылку на dashboard или логи;
- имеет владельца;
- объясняет первый шаг диагностики;
- не дублирует одно и то же каждые 30 секунд;
- закрывается автоматически при восстановлении;
- фиксируется в истории инцидентов.
Плохой алерт:
- приходит без контекста;
- сообщает о каждом мелком исключении;
- не говорит, что делать;
- приходит в общий чат без владельца;
- срабатывает на нормальные колебания;
- не отличается по критичности;
- шумит ночью из-за некритичной задачи;
- не связан с пользовательским влиянием.
Алерты нужно проектировать как продуктовый интерфейс для команды. Их читает человек в момент стресса, поэтому сообщение должно быть коротким, точным и полезным.
Критичность инцидентов
Не все проблемы одинаковы. Ошибка в редко используемом фильтре и недоступность оплаты требуют разной реакции. Поэтому нужно заранее описать уровни критичности.
Пример классификации:
- P1 - сервис недоступен, массовая потеря заявок, платежи не работают, утечка данных, критический сбой безопасности;
- P2 - не работает важный сценарий для части пользователей, CRM не принимает заявки, очередь критичных задач растет, личный кабинет частично недоступен;
- P3 - есть ошибка в отдельной функции, есть обходной путь, влияние ограничено;
- P4 - косметическая проблема, некритичный баг, улучшение мониторинга или документации.
Критичность должна учитывать не только технический статус, но и бизнес-влияние. Например, падение страницы оплаты в период рекламной кампании может быть P1. Ошибка той же страницы в тестовом окружении - не инцидент для продакшена.
SLA, SLO и SLI простыми словами
В мониторинге часто встречаются SLA, SLO и SLI. Эти термины полезны, если использовать их практически.
SLI - показатель уровня сервиса. Например, процент успешных запросов, время ответа p95, доля доставленных уведомлений, доля успешных платежных webhooks.
SLO - целевое значение. Например, 99,5% успешных запросов API за 30 дней или p95 времени ответа до 800 мс для ключевых endpoints.
SLA - соглашение с клиентом или внутреннее обязательство, часто с последствиями при нарушении. Например, условия договора поддержки или доступности.
Для небольшого веб-сервиса не обязательно начинать с формального SLA. Но полезно определить внутренние SLO: какие сценарии считаются критичными, какой уровень доступности нужен, сколько времени команда готова терпеть деградацию и как быстро реагировать на инциденты.
Google Cloud в архитектурных рекомендациях связывает SLO с метриками и надежностью сервиса. Практический смысл такой: команда должна понимать не только "все ли зеленое", но и какой уровень надежности нужен бизнесу.
Dashboard для команды
Dashboard нужен не для красоты. Он должен помогать быстро понять состояние продукта. Если dashboard содержит 60 графиков без приоритета, им никто не пользуется в инциденте.
Хороший dashboard показывает:
- общий статус сервиса;
- критичные сценарии;
- error rate;
- latency;
- трафик;
- очередь задач;
- платежи;
- CRM-передачу;
- уведомления;
- ресурсы сервера;
- последние deploy;
- активные алерты;
- ссылку на логи;
- статус внешних сервисов.
Для бизнеса полезен отдельный операционный dashboard: заявки за последний час, неотправленные лиды, зависшие платежи, ошибки уведомлений, незакрытые инциденты. Это не заменяет технический dashboard, но помогает менеджерам понимать состояние процесса без доступа к инженерным инструментам.
Инцидент: что делать, когда алерт сработал
Алерт сам по себе не решает проблему. Нужен процесс реакции. Даже простая команда должна заранее понимать, кто смотрит алерты, где фиксируется инцидент, как назначается ответственный и когда бизнес получает статус.
Минимальный процесс:
- получить алерт;
- подтвердить, что проблема реальна;
- определить влияние на пользователей;
- назначить ответственного;
- зафиксировать время начала;
- найти быстрый способ снизить ущерб;
- восстановить сервис;
- проверить, что сценарий работает;
- сообщить заинтересованным;
- оформить причину и действия после инцидента.
При критичном сбое не всегда нужно сразу искать идеальную причину. Сначала важно восстановить сервис или снизить влияние: отключить проблемную функцию, откатить релиз, включить резервный сценарий, остановить рассылку, переключить provider, поставить очередь на паузу, добавить ручную обработку.
После восстановления уже нужно разобраться, почему проблема возникла и как снизить риск повторения.
Постмортем без поиска виноватых
Инциденты неизбежны. Вопрос в том, учится ли команда на них. Постмортем - это разбор после инцидента: что произошло, кого затронуло, как обнаружили, как реагировали, что помогло, что помешало и какие действия нужно выполнить.
Atlassian в материалах по incident management описывает blameless postmortem - разбор без поиска виноватых. Смысл не в том, чтобы снять ответственность, а в том, чтобы найти реальные причины: недостаток мониторинга, слабый deploy-процесс, отсутствие проверки, неочевидная зависимость, ручной шаг, неточный алерт, недостаточная документация.
Хороший постмортем содержит:
- краткое описание;
- время начала и окончания;
- влияние на пользователей;
- затронутые сервисы;
- timeline событий;
- причину или набор причин;
- что сработало хорошо;
- что нужно улучшить;
- конкретные действия;
- владельцев действий;
- сроки выполнения.
Важно, чтобы действия после постмортема были конкретными. Не "улучшить мониторинг", а "добавить алерт на рост failed jobs в очереди платежных webhooks более 5 минут". Не "проверять релизы внимательнее", а "добавить pre-release check для миграции поля payment_status".
Мониторинг безопасности
Мониторинг безопасности не заменяет защиту, но помогает быстрее увидеть подозрительные события.
Что стоит отслеживать:
- множество неуспешных входов;
- перебор кодов подтверждения;
- входы администраторов с необычных IP;
- массовое скачивание файлов;
- изменение ролей;
- создание новых администраторов;
- ошибки проверки прав;
- попытки доступа к чужим данным;
- рост 401 и 403;
- подозрительные API-запросы;
- изменение критичных настроек;
- загрузку опасных файлов.
Не каждый сигнал безопасности должен идти в общий технический чат. Часть событий нужно сохранять в audit log, часть отправлять ответственному, часть поднимать как инцидент. Например, ошибка пароля обычного пользователя не критична, а массовые попытки входа в админку ночью - уже повод для реакции.
Связь мониторинга и защиты подробнее можно раскрывать через статью Безопасность веб-сервиса. В продакшене безопасность важна не только в коде, но и в наблюдении за событиями.
Мониторинг релизов
Многие инциденты начинаются после изменений: новый deploy, миграция базы, изменение конфигурации, обновление зависимости, правка интеграции, новый шаблон уведомлений, изменение CRM-поля. Поэтому мониторинг должен быть связан с релизами.
Что полезно:
- фиксировать версию релиза в логах;
- отмечать deploy на графиках;
- сравнивать ошибки до и после релиза;
- иметь быстрый rollback-план;
- проверять ключевые сценарии после deploy;
- разделять ошибки старой и новой версии;
- не выпускать критичные изменения без наблюдения.
Если после релиза вырос error rate, команда должна видеть это сразу. Если изменения затронули платежи или заявки, первые реальные операции нужно проверять особенно внимательно.
Мониторинг данных
Иногда сервис технически работает, но данные становятся неправильными. Для бизнеса это не менее опасно, чем падение сайта.
Примеры:
- заявки сохраняются без телефона;
- документы привязываются не к той компании;
- платежи получают неверный статус;
- импорт создает дубли;
- CRM получает неверный источник;
- пользователь видит не свою запись;
- остатки устарели;
- отчет считает неверную сумму;
- уведомление уходит не тому получателю.
Часть таких проблем нельзя поймать обычным uptime. Нужны проверки качества данных: ограничения в базе, валидация, сверки, контроль аномалий, отчеты о расхождениях, audit log и ручные выборочные проверки после релизов.
Для проектов с импортом, CRM, 1С, платежами и документами такие проверки особенно важны. Ошибка данных может долго оставаться незаметной, если нет мониторинга расхождений.
Что включить в первый релиз мониторинга
Не обязательно сразу строить сложный observability-контур с десятками инструментов. Но первый релиз веб-сервиса должен иметь базовый мониторинг, иначе после запуска команда будет слепой.
Минимальный набор:
- uptime-проверка критичных страниц;
- контроль SSL-сертификата;
- сбор backend-ошибок;
- сбор frontend-ошибок;
- структурированные логи;
- request ID;
- базовые метрики latency и error rate;
- мониторинг базы данных и диска;
- алерт на недоступность сервиса;
- алерт на рост ошибок;
- контроль очередей;
- контроль резервного копирования;
- контроль CRM-передачи заявок;
- контроль платежных webhooks, если есть платежи;
- контроль отправки уведомлений;
- dashboard для команды;
- регламент реакции на критичные алерты.
Для MVP этого достаточно, чтобы не потерять реальную картину. После запуска можно добавлять трассировку, SLO, подробные dashboards, бизнес-аномалии, постмортем-процесс и расширенный security monitoring.
Что подготовить до запуска
Мониторинг нужно проектировать до релиза, а не после первой аварии. Еще на этапе разработки стоит определить, какие сценарии критичны и что будет считаться сбоем.
Перед запуском нужно подготовить:
- список критичных пользовательских сценариев;
- список внешних сервисов;
- схему заявок, платежей, уведомлений и очередей;
- владельцев компонентов;
- уровни критичности;
- каналы алертов;
- время реакции;
- доступы к логам и dashboards;
- сценарии rollback;
- контактный список;
- план коммуникации при инциденте;
- тестовые synthetic-сценарии;
- список метрик для первого релиза.
Такой список хорошо делать вместе с техническим аудитом перед масштабированием или перед запуском рекламы. Если сервис уже работает, аудит помогает найти слепые зоны: формы без контроля, платежи без сверки, очереди без алертов, логи без структуры, интеграции без повторов.
Связанный материал: Технический аудит веб-проекта.
Как тестирование связано с мониторингом
Тестирование проверяет продукт до релиза. Мониторинг смотрит за продуктом после релиза. Но они должны быть связаны.
Если при тестировании нашли критичный сценарий, его стоит добавить в мониторинг. Если тестируется отправка формы, после запуска нужно контролировать реальные отправки. Если тестируется платеж, в мониторинге должен быть статус webhook. Если тестируется импорт, после запуска нужно видеть ошибки обработки файлов.
Хорошая практика: превращать часть приемочных сценариев в production-safe проверки. Например, не просто вручную проверить форму перед запуском, а добавить synthetic test, который регулярно проверяет безопасный путь отправки.
Подробнее общий pre-release подход описан в статье Тестирование веб-сервиса перед запуском.
Частые ошибки
Первая ошибка - мониторить только главную страницу. Сервис может открываться, но не выполнять ключевые действия.
Вторая ошибка - не разделять технические и бизнес-критичные сигналы. Ошибка в платежах важнее мелкого frontend warning.
Третья ошибка - отправлять все алерты в один чат. Без владельца и критичности уведомления превращаются в шум.
Четвертая ошибка - не хранить request ID и trace ID. Без связи между логами расследование становится медленным.
Пятая ошибка - писать в логи чувствительные данные. Это создает риск безопасности и усложняет соответствие требованиям.
Шестая ошибка - не мониторить внешние сервисы. CRM, платежи, email и API могут сломать процесс, даже если сайт работает.
Седьмая ошибка - не контролировать очереди. Фоновые задачи могут остановиться незаметно.
Восьмая ошибка - не связывать ошибки с релизами. Команда не понимает, какое изменение вызвало сбой.
Девятая ошибка - не проводить разбор инцидентов. Проблемы повторяются, потому что причины не превращаются в задачи.
Десятая ошибка - не проверять мониторинг. Алерт может быть настроен, но не доходить до команды. Такие проверки нужно периодически проводить.
Как Wcoders может подойти к мониторингу
Для Wcoders мониторинг веб-сервиса логично проектировать как часть архитектуры продукта. Если команда разрабатывает личный кабинет, платформу с API, платежный сценарий, CRM-интеграцию, систему уведомлений или админ-панель, нужно заранее определить, как это будет наблюдаться после запуска.
Практический подход:
- определить критичные сценарии бизнеса;
- описать, какие ошибки считаются инцидентом;
- добавить структурированные логи и request ID;
- настроить сбор frontend и backend-ошибок;
- выделить метрики доступности, скорости и ошибок;
- сделать мониторинг очередей и фоновых задач;
- контролировать CRM, платежи, уведомления и внешние API;
- собрать dashboard для команды;
- настроить алерты по критичности;
- описать реакцию на инциденты;
- после запуска анализировать реальные сбои и усиливать слабые места.
Такой подход помогает не просто "поддерживать сайт", а управлять надежностью продукта. Бизнес видит, что происходит, команда быстрее реагирует, а пользователи меньше сталкиваются с незамеченными ошибками.
FAQ
Что такое мониторинг веб-сервиса?
Это система наблюдения за доступностью, скоростью, ошибками, ресурсами, интеграциями, очередями, платежами, уведомлениями и критичными пользовательскими сценариями после запуска.
Чем мониторинг отличается от аналитики?
Аналитика показывает поведение пользователей и эффективность продукта. Мониторинг показывает техническое и операционное здоровье сервиса: работает ли продукт, где ошибки, какие компоненты деградируют и нужен ли инцидентный ответ.
Что мониторить в первую очередь?
Главные страницы, регистрацию, вход, формы, платежи, CRM-передачу, очереди, уведомления, API, базу данных, backend-ошибки, frontend-ошибки и ресурсы сервера.
Нужен ли мониторинг небольшому сайту?
Да, хотя объем может быть меньше. Минимум стоит контролировать доступность, SSL, формы, ошибки, скорость и заявки. Если сайт приносит лиды или продажи, отсутствие мониторинга быстро становится бизнес-риском.
Что такое алерт?
Алерт - это уведомление команде о проблеме, которая требует внимания. Хороший алерт связан с влиянием на пользователей или бизнес, содержит контекст и ведет к понятному действию.
Что такое инцидент?
Инцидент - это событие, которое нарушает работу сервиса или снижает качество важного сценария и требует реакции. Например, недоступность сайта, сбой оплаты, потеря заявок или массовая ошибка входа.
Нужно ли проводить постмортем после каждого сбоя?
После критичных и повторяющихся инцидентов - да. Для мелких ошибок достаточно задачи на исправление. Постмортем нужен, когда важно понять причины, влияние и действия, которые снизят риск повторения.
Когда подключать мониторинг?
До запуска или вместе с первым релизом. Если подключить мониторинг после проблем, часть данных уже будет потеряна, а команда не сможет точно восстановить картину.
Итог
Мониторинг веб-сервиса после запуска - это не техническая роскошь, а основа надежной эксплуатации. Он помогает видеть доступность, скорость, ошибки, очереди, платежи, уведомления, CRM, API, ресурсы и реальные пользовательские сценарии.
Хороший мониторинг отвечает не только на вопрос "сайт работает?", а на более важный вопрос: "может ли пользователь выполнить целевое действие, а бизнес получить корректный результат?" Для этого нужны метрики, логи, трассировка, алерты, dashboard, классификация инцидентов и понятный процесс реакции.
Если веб-сервис принимает заявки, деньги, документы, заказы, партнерские действия или внутренние процессы, мониторинг должен быть заложен в архитектуру с первого релиза. Иначе продукт может выглядеть доступным снаружи, но терять ценность внутри.
Хотите запустить похожий проект?
Опишите задачу, и команда Wcoders подскажет, какой формат подойдет: MVP, Telegram Mini App, веб-сервис, интеграция или аудит текущего продукта.