Сервис уже приносит заявки или платежи, а о сбоях команда узнает от клиентов.
Эксплуатация / Надежность
Надежность веб-сервиса после запуска
После релиза важно видеть, проходят ли заявки и платежи, работают ли интеграции и можно ли восстановить данные при сбое. Выстраиваем наблюдение, порядок реакции и понятный план развития сервиса.
Сценарииконтроль заявок, оплат, входа и API
Данныекопии и проверка восстановления
Релизыпроверка изменений и план отката

Когда подходит
С какими задачами приходят в это направление
Здесь цена сбоя измеряется потерянными действиями пользователей, временем команды и доверием клиентов.
Есть интеграции, очереди и фоновые задачи, но непонятно, где теряются события.
Резервные копии создаются, однако восстановление давно не проверяли.
Новые версии выходят регулярно, и нужен порядок тестирования, публикации и отката.
Что настраиваем
Контроль, восстановление и безопасные изменения
У каждого критичного сценария должен быть сигнал о проблеме, ответственный и проверенный способ вернуть сервис в рабочее состояние.
Критичные сценарии
Фиксируем, какие действия должны работать всегда: вход, заявки, платежи, документы и обмен с внешними системами.
Мониторинг и алерты
Следим за доступностью, ошибками, скоростью, очередями и интеграциями. Каждый важный сигнал ведет к ответственному.
Резервное копирование
Согласуем допустимую потерю данных и срок восстановления, затем подбираем частоту копий и отдельное хранилище.
Проверка восстановления
Разворачиваем копию в отдельной среде и проверяем данные вместе с ключевыми пользовательскими действиями.
Безопасные изменения
Определяем проверки перед выпуском, наблюдение после него, способ отката и порядок разбора повторяющихся сбоев.
Подход
Как выстраиваем работу после релиза
Начинаем с того, что влияет на клиентов и деньги. Затем проверяем сигналы, восстановление и порядок действий команды на реальном сценарии.
Определяем важное
Вместе фиксируем заявки, оплату, вход, документы и другие действия, без которых сервис теряет ценность.
Настраиваем сигналы
Проверяем доступность и прохождение сценариев, собираем ошибки и отправляем ответственным только полезные алерты.
Проверяем восстановление
Согласуем допустимую потерю данных и время простоя, делаем копии и пробуем восстановить сервис в отдельной среде.
Закрепляем порядок
Определяем ответственных, шаги при сбое, проверки после релиза и задачи по устранению повторяющихся причин.
Услуги
Какие направления Wcoders обычно подключаются
Подключаем инфраструктуру, безопасность, интеграции и миграцию данных там, где они влияют на устойчивость продукта.

DevOps / CI/CD / Cloud
DevOps-инфраструктура, CI/CD и облачные серверы
Проект уже развивается, и ручная загрузка файлов на сервер становится рискованной.
Открыть направление
Performance / Security / Scale
Скорость, безопасность и масштабирование веб-сервисов
Сайт или сервис медленно открывается на мобильных устройствах.
Открыть направление
API / Databases / Integrations
Интеграция с API, CRM, 1С и базами данных
Заявки, заказы, оплаты или статусы должны уходить в CRM, 1С или ERP.
Открыть направление
Migration / Replatforming / SEO
Миграция данных и перенос на новую архитектуру
Нужно уйти с WordPress, конструктора или устаревшей CMS без потери SEO.
Открыть направлениеКейсы
Релевантные проекты Wcoders
Эти проекты показывают работу с наблюдаемостью, обработкой событий, вычислительной инфраструктурой и важными финансовыми сценариями.
Формат: Реализованный проект
Платформа наблюдаемости для микросервисов
Платформа на Go, которая собирает метрики, логи и traces из микросервисов, связывает события по trace_id и помогает быстро находить узкие места.
Открыть кейс
Формат: Архитектурная проработка
Сервис обработки событий в реальном времени
Production-ready сервис для real-time обработки событий: правила создаются через API, компилируются в быстрые проверки, применяются без перезапуска и масштабируются на несколько инстансов.
Открыть кейс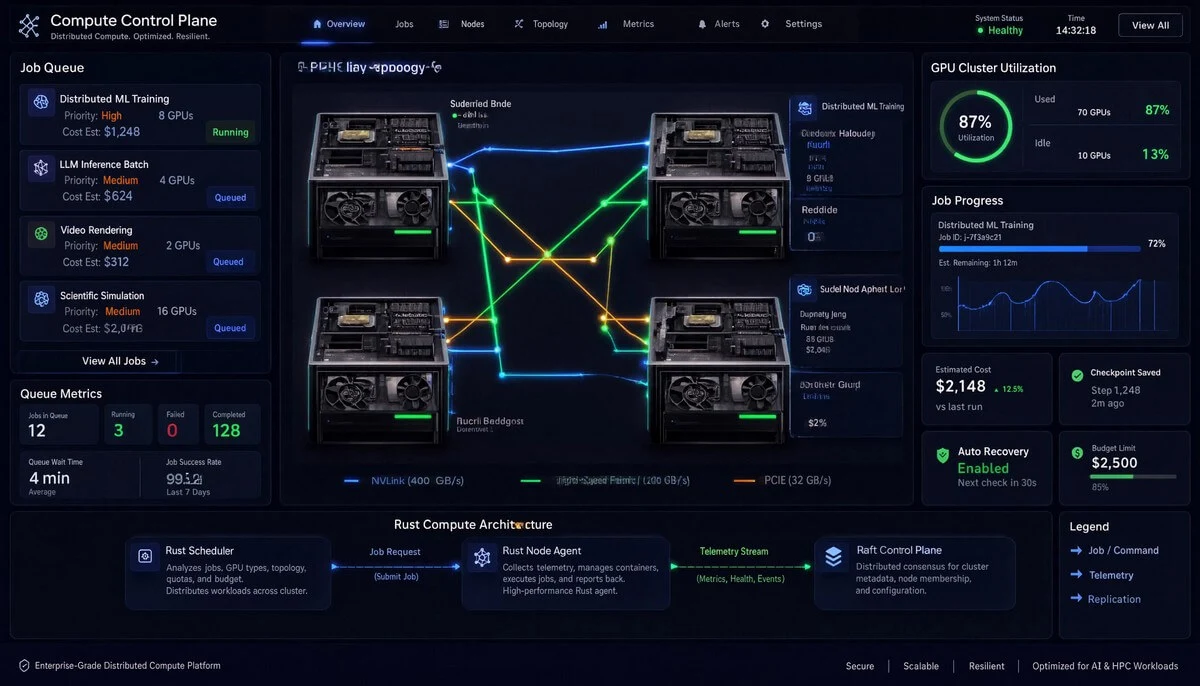
Формат: Архитектурная проработка
Платформа распределенных вычислений для GPU-кластеров
Платформа управления вычислительными мощностями: пользователи отправляют ML, inference, rendering или data jobs, а система подбирает ресурсы, запускает workloads и контролирует расходы.
Открыть кейс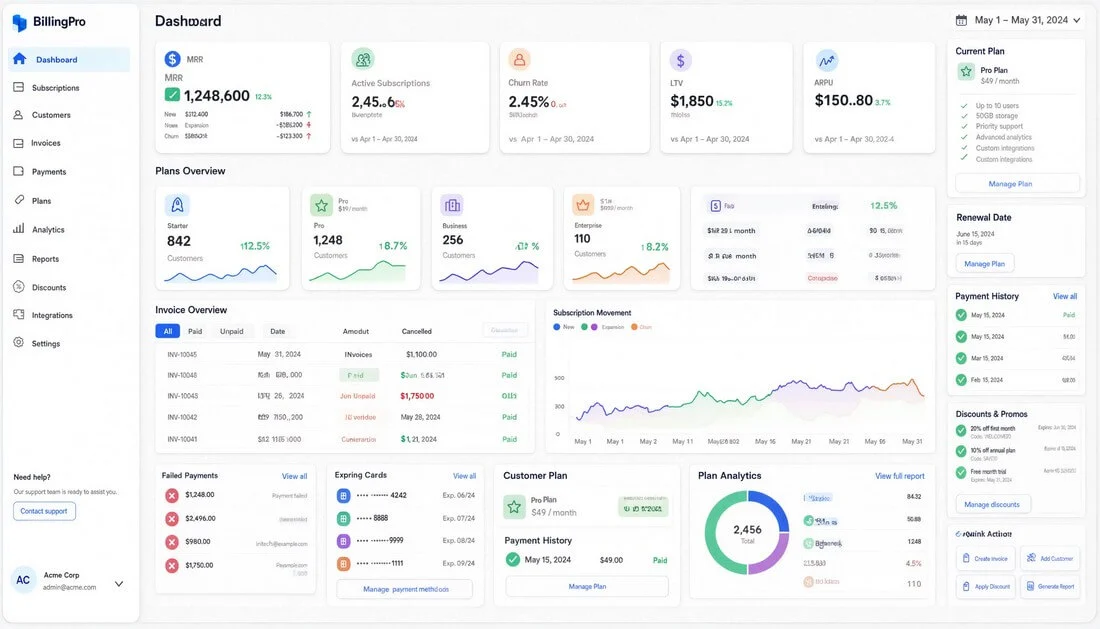
Формат: Реализованный проект
Платформа для подписок и биллинга SaaS-продуктов
SaaS billing-платформа с управлением тарифами, подписками, платежами, инвойсами, продлениями, возвратами, webhooks и аналитикой доходов.
Открыть кейсМатериалы
Как готовиться к работе после запуска
Разбираем мониторинг, резервные копии, тестирование и сопровождение на уровне конкретных решений и действий команды.
27 мин чтения
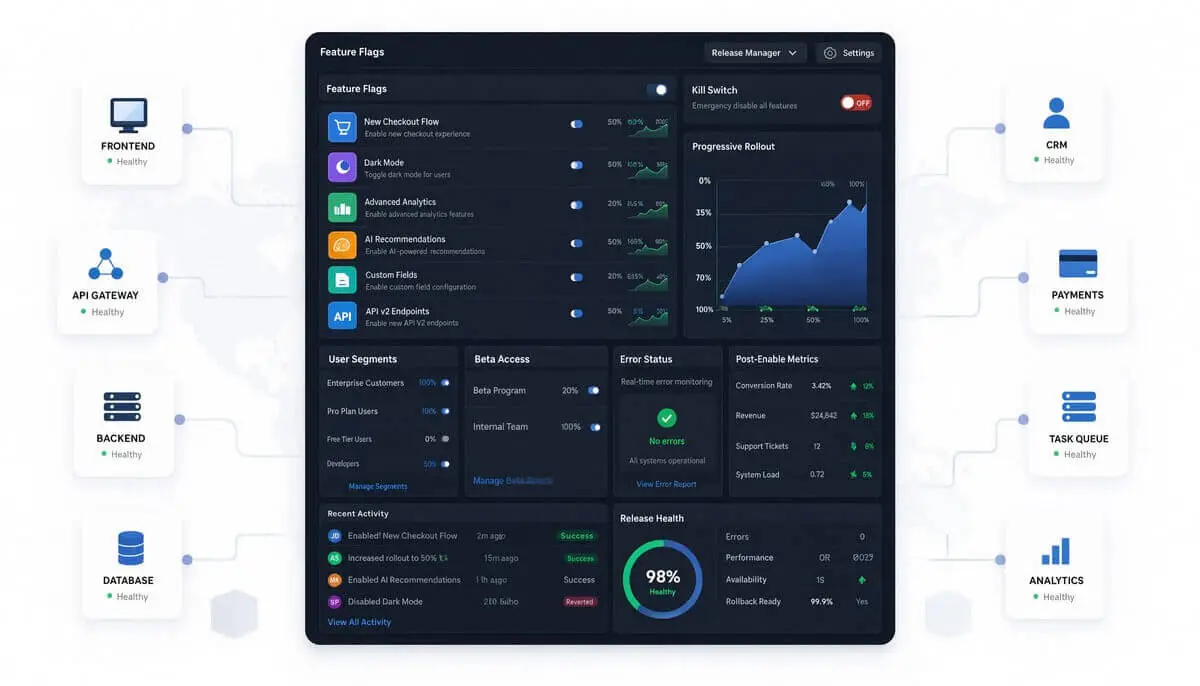
Feature flags в веб-сервисе: как снижать риск релиза
Когда нужны флаги функций, как включать новое для части пользователей, следить за результатом и не превращать релизы в набор скрытых условий.

26 мин чтения
Мониторинг веб-сервиса после запуска: доступность, ошибки, алерты и инциденты
Разбираем, как настроить мониторинг веб-сервиса после запуска: uptime, ошибки, логи, метрики, трассировку, алерты, инциденты, SLA, SLO, dashboard, платежи, очереди, CRM и реакцию команды.

26 мин чтения
Резервное копирование веб-сервиса: бэкапы, восстановление, данные и план аварийного отката
Разбираем, как спроектировать резервное копирование веб-сервиса: какие данные сохранять, как часто делать бэкапы, где хранить копии, что такое RPO и RTO, как проверять восстановление и готовить план аварийного отката.

24 мин чтения
Поддержка и развитие веб-проекта после запуска: что входит, зачем нужна и как не потерять продукт
Разбираем поддержку сайта, веб-сервиса, MVP или цифровой платформы после запуска: мониторинг, безопасность, SEO, SLA и развитие.
28 мин чтения
Безопасность веб-сервиса: роли, персональные данные, файлы, API, платежи и админ-панель
Практическая карта безопасности веб-сервиса: роли, персональные данные, файлы, API, платежи, админ-панель, логи, интеграции и проверки перед запуском.

39 мин чтения
Тестирование веб-сервиса перед запуском: формы, роли, платежи, мобильная версия и интеграции
Практический чек-лист проверки веб-сервиса перед запуском: формы, роли, платежи, мобильная версия, CRM, 1С, аналитика, безопасность и SEO.

28 мин чтения
Очереди и фоновые задачи в веб-сервисе: платежи, рассылки, обмен с CRM и обработка ошибок
Объясняем, зачем веб-сервису очереди и фоновые задачи: платежные webhooks, CRM, рассылки, импорт файлов, отчеты, retry, DLQ и мониторинг.
26 мин чтения
Технический аудит веб-проекта: какие ошибки мешают росту, рекламе и SEO
Разбираем, зачем нужен технический аудит сайта или веб-сервиса, какие ошибки мешают индексации, рекламе, SEO, скорости, заявкам, аналитике и развитию проекта, и что проверять до масштабирования.
Вопросы
Что важно понять до старта
Собрали ответы на частые вопросы, которые обычно влияют на бюджет, сроки и архитектуру проекта.
Достаточно ли проверять, что главная страница открывается?
Нет. Страница может открываться, пока заявки не попадают в CRM или платежи остаются без статуса. Проверяем действия, от которых зависит работа бизнеса.
Как понять, сколько резервных копий нужно?
Сначала определяем, сколько данных допустимо потерять и как быстро сервис должен восстановиться. От этого зависят частота копий, место хранения и порядок проверок.
Что происходит после инцидента?
Команда восстанавливает критичные сценарии, проверяет данные и уведомляет ответственных. Затем разбирает причину, фиксирует изменения и проверяет, что аналогичный сбой будет замечен раньше.
Хотите понять, как это применить к вашему проекту?
Расскажите, что нужно запустить или улучшить. Мы вернемся с первыми вопросами и предложим реалистичный формат старта.