GPU / Rust / Distributed Computing
Формат: Архитектурная проработкаПлатформа распределенных вычислений для GPU-кластеров
Compute Control Plane на Rust для объединения CPU- и GPU-серверов в единый вычислительный пул с очередями, квотами, биллингом и observability.
Исходная задача
Компании, которые используют GPU для AI, рендеринга, data science и тяжелой аналитики, часто теряют деньги на простоях и ручном управлении серверами. Одни команды ждут свободные мощности, другие держат GPU незагруженными, маленькие задачи блокируют крупные distributed workloads, а стоимость экспериментов сложно посчитать по проектам и командам.
Что проработали
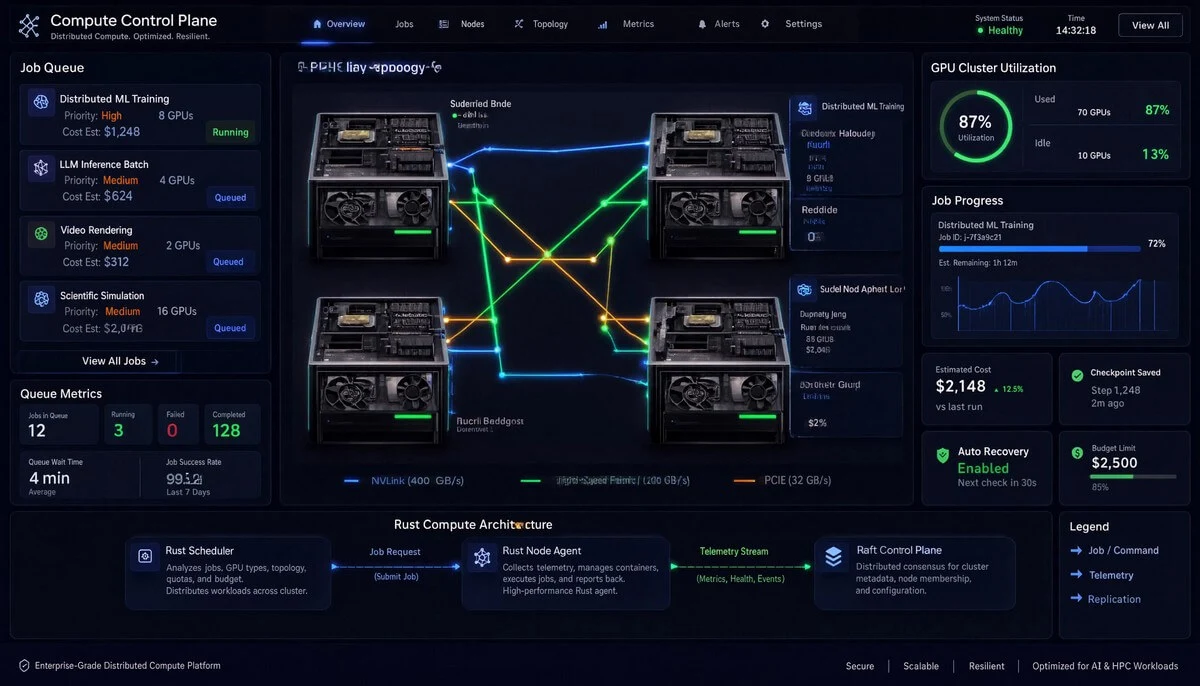
Спроектирован Compute Control Plane на Rust: центральный планировщик принимает задачи через web-интерфейс, CLI и API, учитывает тип GPU, память, загрузку, interconnect, квоты, бюджет и приоритеты, после чего запускает контейнеризированные workloads через node-agent на вычислительных серверах. Система поддерживает очереди, fair-share, backfilling, gang scheduling для распределенного обучения, checkpointing и сбор метрик.
Результат проработки
Разрозненные CPU- и GPU-серверы превращаются в управляемую вычислительную фабрику. Команды получают быстрый доступ к ресурсам без ручной настройки, руководители видят расходы по проектам, а инфраструктура эффективнее использует дорогостоящие GPU и устойчивее переживает сбои нод.
Задача платформы
- Объединить CPU- и GPU-серверы в единый пул ресурсов.
- Принимать задачи через web-интерфейс, CLI и API.
- Выбирать подходящие GPU по типу, памяти, загрузке и топологии.
- Запускать batch jobs, inference, distributed training, rendering и пользовательские контейнеры.
- Показывать прогресс, логи, метрики, расходы и состояние кластера.
Ключевые модули
- Compute Marketplace — выбор сценария, конфигурации, прогноза стоимости и времени запуска.
- Rust Scheduler — topology-aware планирование по GPU, CPU, RAM, interconnect, квотам и бюджету.
- Node Agent — обнаружение ресурсов, запуск контейнеров, подключение GPU, стриминг логов и health status.
- Queue and Fair-Share Engine — очереди, project quotas, priority queues, reservation windows и backfilling.
- Distributed Training Controller — gang scheduling для PyTorch Distributed, DeepSpeed, Ray, TensorFlow и MPI.
Наблюдаемость и финансы
- В реальном времени отображаются загрузка GPU, CPU, память, VRAM, температура, power draw и состояние задач.
- Система считает GPU-seconds, CPU-hours, RAM-hours, storage usage, network egress и стоимость по проектам.
- Dashboard показывает очередь, прогресс, error logs, прогноз завершения, расходы и utilization кластера.
- Для руководителей доступны cost per team, cost per project и контроль бюджета по задачам.
Безопасность
- Изоляция проектов по namespace, сети и storage.
- RBAC, OIDC/SSO, service accounts и short-lived tokens для job execution.
- Шифрование данных in transit и at rest.
- Secrets не попадают в логи и не хранятся в Docker image.
- Audit trail фиксирует, кто, когда и с какими ресурсами запускал вычисления.
Еще кейсы
Другие проекты Wcoders
Посмотрите другие проекты, чтобы оценить разные форматы задач и решений.
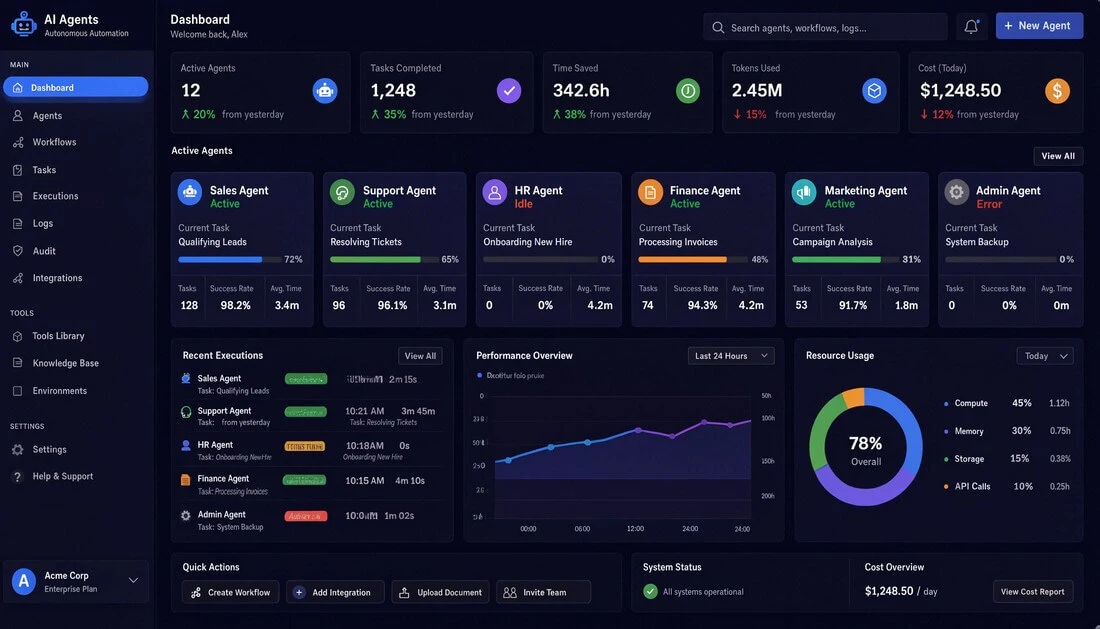
Платформа AI-агентов для автоматизации бизнес-процессов
AI-платформа для автоматизации заявок, документов, онбординга, отчётности и интеграций через автономных агентов и мультиагентные сценарии.
Открыть кейс
Humagent — операционная система для команд из людей и AI
Humagent превращает нейросети из отдельных AI-чатов в управляемых участников компании: с ролями, задачами, знаниями, бюджетами, согласованиями и прозрачной историей запусков.
Открыть кейс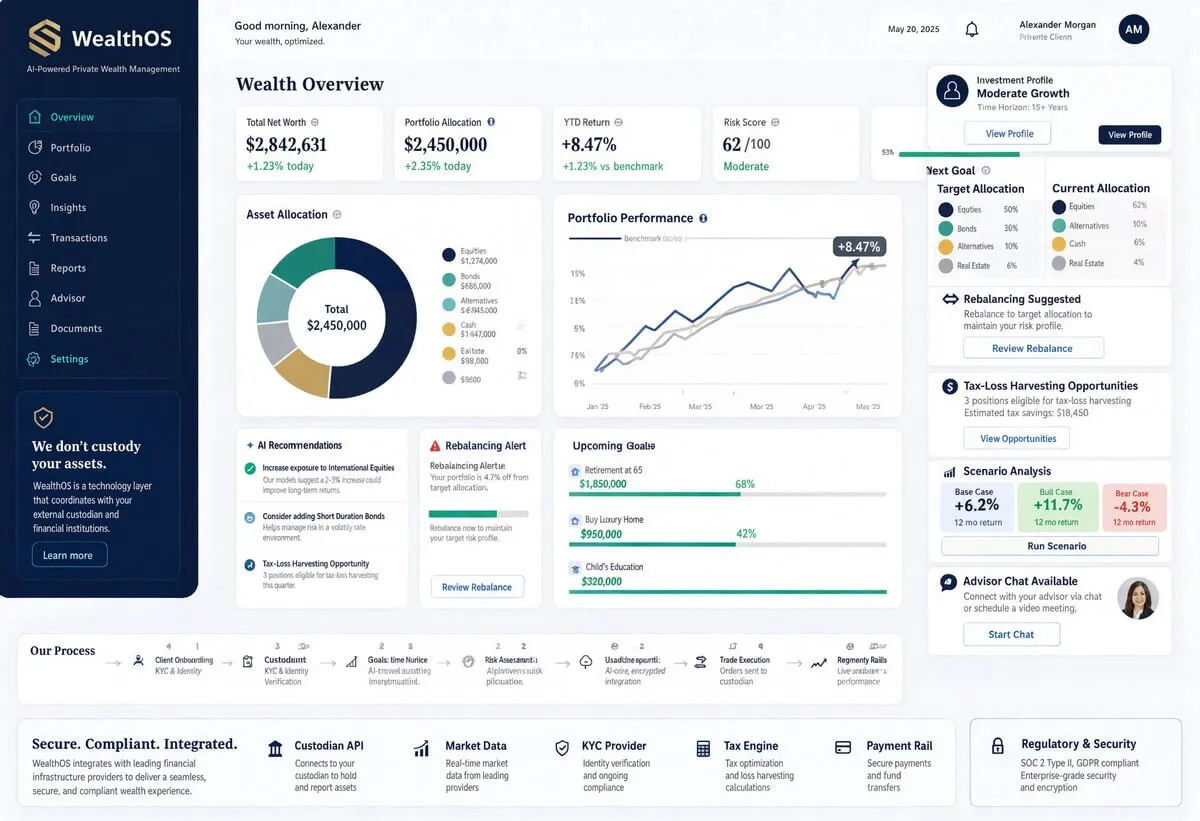
WealthOS — платформа цифрового управления капиталом
Концепт цифровой платформы для wealth-менеджеров, семейных офисов, брокеров и финтех-компаний: управление капиталом, робо-эдвайзинг и гибридное консультирование.
Открыть кейс